Consensus : j'ai engagé cinq IA pour relire mon code (et elles se chamaillent)
Il est 2h du matin. Vous venez de pousser un commit parce que “c’était le dernier refactor, promis”. Qui relit ce code ? Un humain ? Il dort. Alors imaginez un panel de cinq IA qui s’y met, tout de suite, en parallèle et qui se dispute dessus.
C’est exactement ce que fait Consensus et cet article raconte comment.
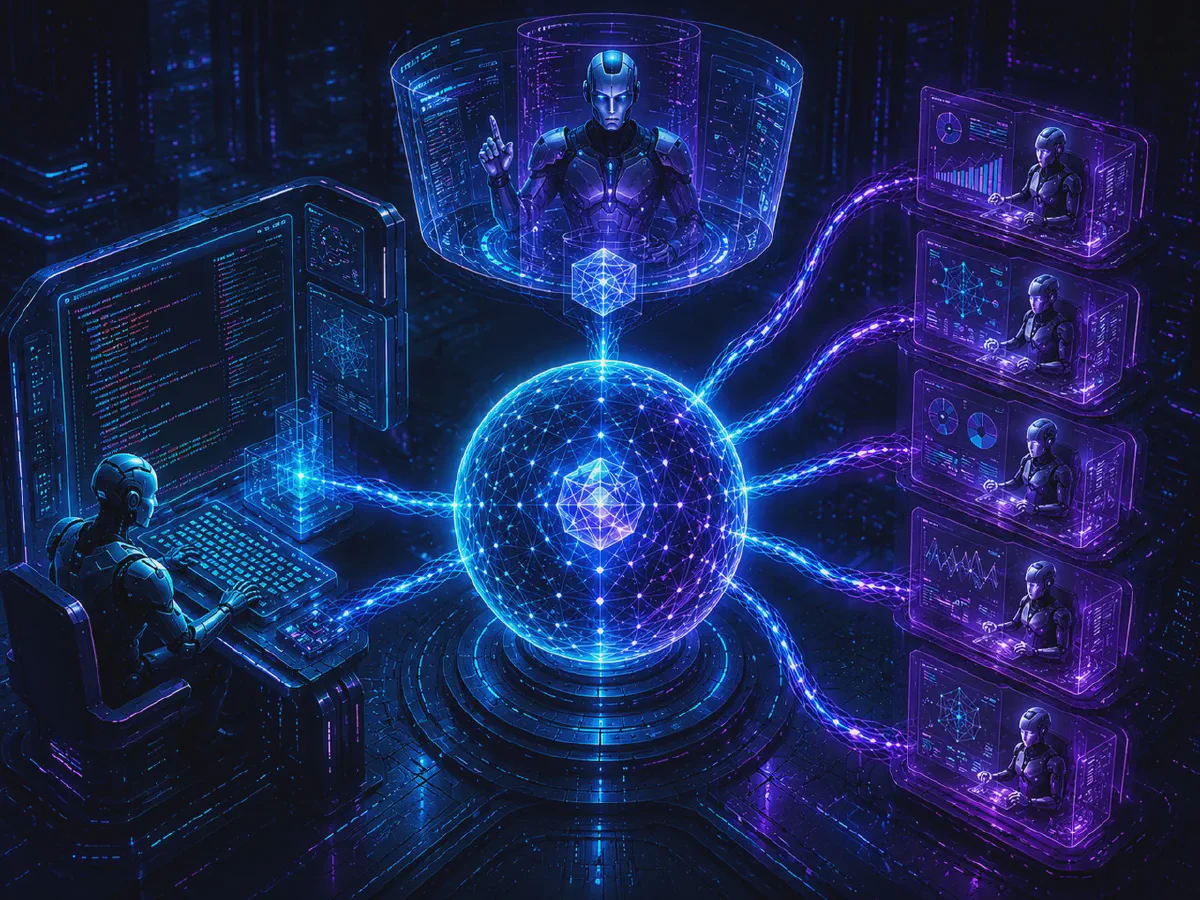
La troupe
Le casting tient en quatre rôles, un peu comme une sitcom de bureau :
- coder : le stagiaire survolté. On lui donne une spec, il crache du code. Rapide, confiant, parfois exaspérant.
- le panel : une poignée de reviewers en parallèle. Chacun a son modèle, sa personnalité et surtout son avis.
- consensus : le comptable. Il regarde qui a signalé quoi et calcule un score d’accord.
- lead : le boss. Il lit tout, tranche et signe le code final.
Le flux tient sur un post-it :
spec -> coder -> panel (en parallèle) -> consensus -> lead
Et tout est streamé au navigateur en SSE : les reviews arrivent une par une, comme des colocataires qui rentrent un par un pour disputer la vaisselle.
Pas de LangChain et on assume
Le premier réflexe serait de sortir le framework d’agents du placard. Ici, non : deux transports HTTP écrits à la main avec httpx, un format OpenAI-compatible et un format Anthropic. Environ 500 lignes, chaque couche est lisible et quand ça casse à 3h du matin (il y a une thématique), vous lisez le code, pas la stack trace d’une abstraction à sept niveaux.
Coût assumé : réimplémenter le retry et le streaming. Bénéfice : on sait exactement ce qui part sur le réseau.
Le videur du club
Tous les appels passent par le governor : le videur du club. Rate limit par provider (aiolimiter), retry (tenacity) et une chaîne de fallback si un provider fait grève.
Le détail que j’adore : les 429 et les erreurs de connexion sont retentés par deux couches volontairement disjointes. Pourquoi ? Parce que la couche HTTP est la seule à pouvoir lire l’en-tête Retry-After. Si les deux couches retentaient les 429, un échec donnerait (N+1)² tentatives. Le code documente ce piège noir sur blanc, parce qu’un jour, quelqu’un allait le faire.
Et si le quota s’effondre, le mode low-quota s’enclenche tout seul : des modèles cheap pour le gros du travail. Mais le lead n’est jamais dégradé. Le boss garde son bon café, c’est lui qui signe.
Toujours un lent de la bande
Cinq reviewers en parallèle, il y en a toujours un qui prend son temps (bonjour Opus). La première idée est asyncio.gather : on attend tout le monde. La deuxième est asyncio.as_completed : chaque review est streamée dès qu’elle arrive, pas besoin d’attendre le dernier de la classe.
Effet secondaire subtil : compter les tokens sous cette concurrence. Réponse : les contextvars, qui se propagent dans les tasks. Un usage_scope() englobe tout le run et chaque appel se compte tout seul, sans passer une liste à travers chaque fonction.
On ne fait JAMAIS confiance au modèle (et on a raison)
Le point le plus important du projet et le moins glamour : le score de consensus n’est pas ce que le modèle raconte. Le modèle propose flagged_by (qui a signalé quoi), le code vérifie :
- les noms inconnus sont rejetés (un reviewer fantôme ? dehors),
- les doublons sont dédupliqués,
- le score est recalculé en Python :
round(min(len(flagged), n) / n, 3), mathématiquement clampé à 1.0.
Un LLM est une hypothèse, le code est la vérité. C’est le genre d’invariant qui sauve un projet.
Le consensus n’est pas la vérité
Et pourtant, le score recalculé en Python ne règle qu’une partie du problème: il garantit que l’accord est bien compté, pas que l’accord est juste. La littérature récente le dit mieux que moi. Le mal des LLM en revue de code, ce n’est pas tant ce qu’ils ratent que ce qu’ils inventent: des rapports plausibles mais faux qui noient les mainteneurs. Le papier Refute-or-Promote (arXiv 2604.19049 ) chiffre le remède avec des kill mandates adversariaux et un gate empirique obligatoire. Il tue 79 à 83% des candidats avant divulgation. QASecClaw (arXiv 2605.01885 ) retire 88,6% de faux positifs (F1 90,93% contre 78,39% pour Semgrep seul). L’étude Tencent (arXiv 2601.18844 ) élimine 94 à 98% de fausses alertes à $0,0011-$0,12 l’alarme, contre 10 à 20 minutes d’inspection manuelle. Et le single-pass plafonne à un F1 de 19,38% (zylos ).
Le multi-modèle aide sans suffire: une même famille de modèles partage les mêmes angles morts; c’est le critic cross-family de Refute-or-Promote qui attrape ce que le same-family rate. AgentAudit (dev.to ) pousse plus loin avec un vote pondéré (quorum de 5, seuil de 60%) et une résistance Sybil. zylos documente l’agreeableness bias: un modèle qui relit sa propre sortie hérite des biais qui l’ont produite, ce qui justifie le panel de modèles différents que Consensus déploie déjà.
Mais la leçon la plus glaçante vient de Refute-or-Promote: dix reviewers dédiés ont validé à l’unanimité une oracle Bleichenbacher qui n’existait pas dans le module CMS d’OpenSSL. Dix, unanimes, dans l’erreur. La bête n’a été tuée que par un seul test empirique. C’est le contrepoint exact à la règle du projet: le consensus, même parfait, n’est pas la vérité, c’est un test qui tranche.
Alors voici la mise au point. Consensus fait déjà bien trois choses que la littérature recommande: le panel multi-modèle (contre l’agreeableness bias), le score recalculé en code (jamais la parole du modèle) et la méfiance envers le modèle. Ce qu’il pourrait ajouter: un gate empirique, valider un finding par un test avant de l’accepter; une diversité cross-family assumée dans le panel; des findings structurés avec confidence et numéro de passe pour filtrer le bruit; et une chaîne de provenance en log append-only. Le stagiaire écrit, la bande critique, le comptable compte, le boss signe. Le test, lui, reste à écrire.
Le JSON déchiré, réparé, redemandé
Les LLM renvoient du JSON comme un gamin renvoie une carte de voeux : froissé. Trois couches de réparation : json.loads, puis raw_decode depuis le premier { (au revoir les fences markdown et la prose), puis json_repair en dernier recours. Échec final ? On redemande avec un hint glissé au prompt et le lead monte max_tokens à chaque tentative, parce que la troncature est la cause numéro 1 d’un JSON déchiré.
Le run se termine TOUJOURS
La règle du projet : une exécution donne toujours un résultat. Un reviewer meurt ? Il est sauté. Le consensus meurt ? Le lead arbitre sur les reviews brutes. Le lead meurt ? Verdict dégradé, mais il transporte quand même le code du stagiaire. L’UI ne montre jamais un écran vide et c’est étonnamment plus dur que ça n’en a l’air.
Le code généré va en cage
Parce que le coder écrit du code qui sera exécuté, le sandbox Docker applique le menu de sécurité complet : --network none (pas d’exfiltration), --read-only, --cap-drop ALL, pas de nouveaux privilèges, limite de processus, un tmpfs noexec de 64 Mo comme seule zone writable, le workspace monté en lecture seule, timeout avec kill. Le code généré est une entrée, jamais un invité de confiance.
Ping, ping, ping
Détail de production : un appel Opus peut rester silencieux 75 secondes et les proxies en profitent pour tuer la connexion. Solution : un heartbeat SSE qui émet ": ping" toutes les 10 secondes quand rien ne se passe. Les commentaires SSE sont ignorés par les clients, les proxies sont rassurés, tout le monde est content.
Les chiffres
- environ 2 600 lignes d’orchestration (9 modules),
- 5 providers intégrés, activés par leur clé d’environnement,
- environ 301 tests, 100 % hors ligne,
- du mutation testing (mutmut) : les tests sont durcis contre les mutants, pas seulement verts,
- 4 équipes déclarées en YAML : consensus, consensus-testé, pentest, sre.
Et pour en ajouter une couche
Ajouter un domaine (une équipe pentest, une équipe sre…) = un fichier teams/<nom>.yaml. Zéro code. Les skills, les tools MCP, le RAG et le sandbox se déclarent dans le manifest.
Voilà. Le stagiaire écrit, la bande critique, le comptable compte, le boss signe. Et vous, vous dormez enfin.